內容目錄
明明可以正常開啟 PDF 文件,卻無法選取文字、複製內容,甚至按下 Ctrl + C 也沒有反應?這種情況常見於掃描文件、紙本書籍轉成的 PDF、圖片型報告,以及部分受到安全性限制的文件。
遇到這類問題,不一定需要重新製作文件,也不必急著更換 PDF 閱讀器。只要先判斷 PDF 無法複製文字的原因,再選擇合適的 OCR(光學字元辨識)工具,就有機會將圖片中的文字轉換成可以搜尋、選取及複製的內容。
本文將說明 PDF 無法複製文字的常見原因、OCR 的運作方式、Windows 常用工具、完整操作流程,以及辨識結果出現亂碼時的處理方法。
一、PDF 為什麼無法複製文字?
PDF 無法複製文字,通常可以分成以下幾種情況。先確認問題類型,能避免使用錯誤的方法反覆嘗試。
PDF 是掃描圖片,沒有真正的文字內容
這是最常見的原因之一。
例如,將紙本合約、書籍、收據或講義放進掃描器,掃描後儲存成 PDF。雖然文件看起來有完整的文字,但每一頁實際上可能只是一張圖片。
這類 PDF 的內容是影像,而不是可選取的文字,因此無法直接反白、複製或使用 Ctrl + F 搜尋文件中的關鍵字。
解決方法:使用 OCR 文字辨識,將圖片中的文字轉換成可搜尋的文字層。
PDF 有文字,但無法正常選取
如果文件不是掃描圖片,卻仍然無法複製文字,可能與 PDF 的安全性設定、文件權限、閱讀器功能或檔案本身的結構有關。
可以先嘗試:
-
使用其他 PDF 閱讀器開啟文件。
-
確認是否可以用滑鼠反白文字。
-
查看文件的安全性或權限資訊。
-
確認文件是否要求密碼,或限制文字複製。
如果是權限限制,OCR 不一定是正確的解決方式。應先確認自己有權存取及處理該文件,再依文件授權與安全性設定採取適當措施。
PDF 只有部分頁面不能複製
有些文件是由原生文字頁面與掃描圖片頁面混合而成。例如,前幾頁可以複製,後面的附件卻完全無法選取。
這代表文件可能只有部分頁面具有文字層。
遇到這種情況,不必一定要將整份 PDF 重新辨識,可以先確認哪些頁面缺少文字層,再針對需要的頁面執行 OCR。
PDF 可以複製,但貼上後出現亂碼
這種情況與掃描圖片不同。PDF 可能包含特殊字型、錯誤的文字編碼,或無法正常對應的字元映射。
如果反白時看得到文字,複製後卻出現亂碼、缺字或錯誤符號,可以嘗試:
-
使用其他閱讀器重新複製。
-
將 PDF 轉換成 Word 或純文字,再檢查內容。
-
若原始文字層確實無法正確讀取,才考慮使用 OCR 重新辨識。
需要注意的是,OCR 也可能產生錯字,因此重要文件仍然需要人工校對。
二、什麼是 OCR?為什麼能解決 PDF 無法複製文字?
OCR 是 Optical Character Recognition 的縮寫,中文稱為「光學字元辨識」或「光學文字辨識」。
簡單來說,OCR 能分析圖片中的文字形狀,判斷每個字元可能代表什麼,再將辨識結果建立成電腦可以讀取的文字。
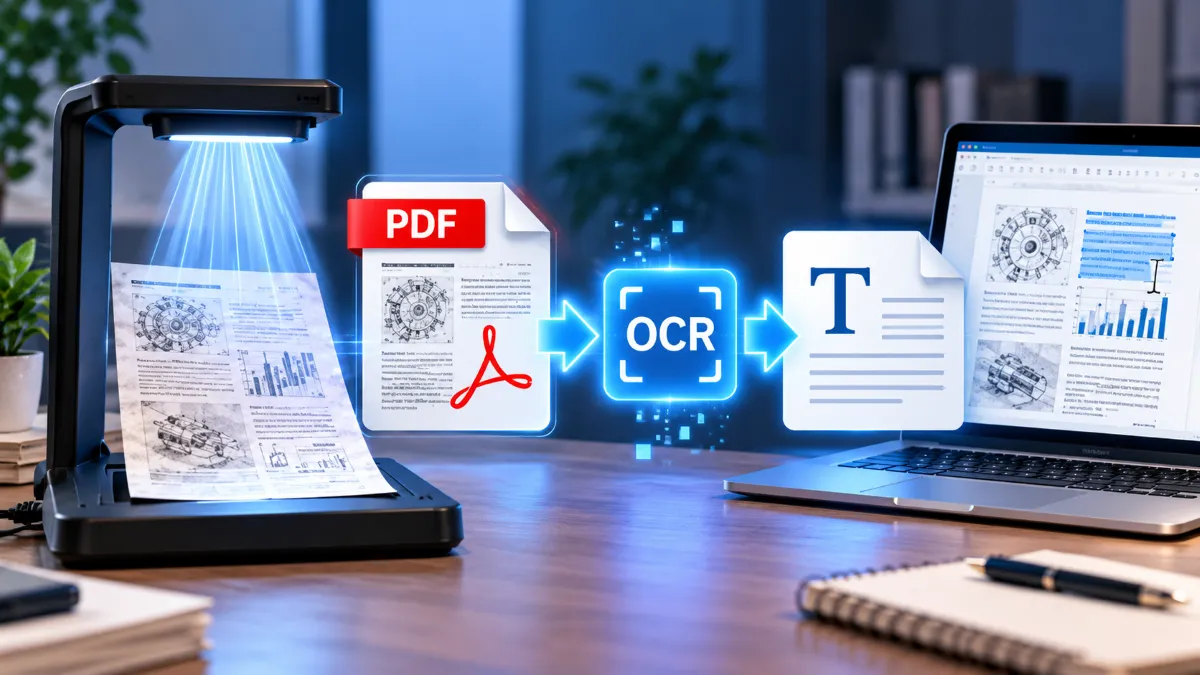
一般掃描 PDF 的處理流程如下:
-
原始 PDF: 每一頁只有文字圖片,無法直接選取內容。
-
執行 OCR: 軟體分析圖片中的文字、行距與版面。
-
建立文字層: 在 PDF 中加入可搜尋、可選取的文字資訊。
-
重新儲存: 產生可以搜尋關鍵字、反白及複製文字的 PDF。
部分 OCR 工具也能將辨識結果匯出成 TXT、Word 或其他格式,方便後續編輯。
不過,OCR 並不是百分之百準確。文件解析度、字體、背景雜訊、表格線條、直排文字,以及繁體中文與英文混排,都可能影響辨識結果。
三、PDF 無法複製文字,推薦哪些 OCR 工具?
如果使用 Windows 電腦,可以依照文件數量、隱私需求及是否需要編輯原始版面,選擇適合的工具。
Adobe Acrobat:適合處理完整 PDF 文件
適合對象: 經常處理掃描合約、報告、表格,以及需要保留原始 PDF 外觀的使用者。
Adobe Acrobat 提供掃描與 OCR 功能,可以針對單份 PDF 或多份文件進行文字辨識,並建立可搜尋的文字層。
基本操作方向:
-
開啟掃描 PDF。
-
進入「所有工具」中的「掃描與 OCR」。
-
選擇目前文件的文字辨識功能。
-
設定頁面範圍與辨識語言。
-
執行辨識,檢查結果後儲存。
部分進階功能可能需要付費方案,使用前應確認目前版本的功能與授權。
Microsoft Word:適合將 PDF 轉成可編輯文件
適合對象: 主要目的是將 PDF 內容複製到 Word,或繼續編輯文件的人。
Word 可以開啟 PDF,嘗試將內容轉換成可編輯的文件。如果 PDF 主要由一般文字構成,轉換通常較容易保留內容;但如果是純掃描圖片,仍可能需要先使用 OCR。
操作方式:
-
開啟 Microsoft Word。
-
選擇「檔案」→「開啟」。
-
選取需要處理的 PDF。
-
確認 Word 提示的 PDF 轉換訊息。
-
等待轉換完成,再檢查文字內容。
請留意,Word 轉換 PDF 時可能重新排列段落、表格、圖片及分頁,因此不適合要求版面完全一致的文件。
Microsoft OneNote:適合快速擷取圖片文字
適合對象: 只需要複製幾段文字、整理講義內容或擷取圖片中的資訊。
OneNote 支援對圖片及文件列印影像進行 OCR,可以將辨識出的文字複製到筆記或其他應用程式。
基本方式:
-
將需要辨識的頁面或圖片放進 OneNote。
-
在圖片上按一下滑鼠右鍵。
-
如果選單提供「從圖片複製文字」或類似功能,選取該項目。
-
將文字貼到 Word、記事本或其他編輯器。
-
檢查文字是否完整。
此方法比較適合擷取文字,不一定會直接產生具有完整文字層的 PDF。
OneDrive 手機版:適合在手機上複製掃描 PDF 文字
如果手邊沒有電腦,也可以留意 OneDrive 行動應用程式提供的 OCR 功能。
依 Microsoft 官方說明,部分 OneDrive Android 與 iOS 應用程式正在推出掃描 PDF 文字辨識功能。開啟支援的掃描 PDF 後,可以長按頁面並選擇「辨識文字」,完成後再選取及複製文字。
官方說明:OneDrive PDF 光學字元辨識
功能是否可用,可能受到應用程式版本、裝置及推出進度影響。
四、PDF OCR 文字辨識完整操作教學
以下以 Adobe Acrobat 的桌面版流程為例,說明如何將無法複製文字的掃描 PDF 轉換成可搜尋的文件。
步驟一:先備份原始 PDF
開始之前,先將原始 PDF 複製一份,避免辨識後的文字層、版面或檔案內容發生變化時,無法還原。
例如:
-
原始檔案:
report-original.pdf -
辨識後檔案:
report-ocr.pdf
如果文件包含重要合約、財務報表或工作資料,建議保留原始版本,並將處理後的檔案另存到其他位置。
步驟二:確認 PDF 是否為掃描圖片
開啟 PDF 後,嘗試使用滑鼠選取一段文字,再按下 Ctrl + C,貼到記事本。
觀察結果:
-
可以正常貼上文字: PDF 已經有文字層,問題可能出在特定閱讀器或文字編碼。
-
只能選取整個頁面或圖片: 文件可能是掃描影像,需要 OCR。
-
完全無法選取: 也可能是權限限制或文件結構問題,應進一步確認。
這個步驟可以幫助你判斷是否真的需要執行 OCR。
步驟三:開啟掃描與 OCR 功能
在 Adobe Acrobat 中開啟需要處理的 PDF,找到「所有工具」中的「掃描與 OCR」功能。
接著選擇針對目前文件進行處理的選項,並確認需要辨識的頁面範圍。
如果整份文件都是掃描圖片,可以選擇全部頁面;如果只有部分頁面不能複製文字,則可視功能支援情況,只處理指定頁面。
不同版本的 Acrobat 介面可能略有差異,選單名稱也可能因語言設定而不同。
步驟四:選擇正確的辨識語言
OCR 執行前,應盡量選擇與文件相符的語言。
如果文件主要是繁體中文,可以選擇繁體中文或相應的中文辨識設定;如果內容同時包含英文、數字及中文,也應確認工具是否支援該類混合內容。
語言設定錯誤,可能造成以下問題:
-
繁體中文被辨識成簡體中文。
-
英文字母與數字混淆。
-
標點符號出現錯誤。
-
專有名詞、產品型號或人名辨識不準確。
如果辨識結果很差,可以檢查語言設定後重新執行 OCR。
步驟五:執行 OCR 文字辨識
確認頁面範圍與語言後,按下「辨識文字」或相應的執行按鈕。
軟體會分析文件中的文字影像,並建立可搜尋的文字層。處理時間取決於頁數、圖片解析度、檔案大小與電腦效能。
完成後,先不要急著覆蓋原始檔案,建議另存成新檔案。
步驟六:測試文字是否可以複製
OCR 完成後,進行以下檢查:
-
用滑鼠反白一段文字。
-
按下
Ctrl + C。 -
開啟記事本或 Word,按下
Ctrl + V。 -
檢查文字是否正確、完整。
-
使用
Ctrl + F搜尋文件內的一個關鍵字。
如果可以正常選取、複製及搜尋,通常代表文字層已經建立成功。
但這不代表所有文字都辨識正確,尤其是數字、表格、地址、日期與特殊符號,仍應逐項檢查。
步驟七:修正辨識錯誤並儲存
OCR 可能將相似字元辨識錯誤,例如:
-
0與O -
1與I -
8與B -
中文相似字、標點符號或破折號
如果文件內容需要後續編輯,可以將文字匯出至 Word,再進行段落、表格與文字修正。
如果只需要搜尋及複製內容,則可以保留 OCR 後的 PDF,不必為了方便複製而強制轉換成 Word。
五、OCR 完成後,為什麼還是無法複製文字?
如果已經執行 OCR,卻依然無法選取文字,可以從以下幾個方向排查。
情況一:OCR 沒有成功執行
有些工具只是改善掃描圖片的清晰度,並沒有真正建立文字層。
處理方式: 重新確認使用的功能是否為「辨識文字」或 OCR,而不是單純的影像增強、壓縮或轉檔。
情況二:只辨識部分頁面
如果只針對特定頁面執行 OCR,其他頁面仍可能無法複製。
處理方式: 檢查頁面範圍設定,確認所有需要的頁面都已經完成辨識。
情況三:PDF 受到權限限制
即使文件具有文字層,某些安全性設定仍可能限制複製、列印或編輯。
處理方式: 查看文件的安全性資訊,確認是否存在複製限制。若文件屬於他人或組織,應先取得適當授權,不要擅自繞過保護措施。
情況四:OCR 辨識結果品質不佳
文字可能已經建立,但辨識結果包含大量錯字、缺字或無法理解的符號。
處理方式:
-
重新掃描或取得解析度更高的原始文件。
-
先修正傾斜、陰影及模糊問題。
-
確認辨識語言設定正確。
-
針對錯誤頁面重新執行 OCR。
-
對重要文字進行人工校對。
Adobe 也提供辨識文字校正功能,可以檢查並修正不確定的辨識結果。參考:Adobe Acrobat 修正掃描文字辨識錯誤。
六、OCR 文字辨識不準確,如何提高成功率?
OCR 的結果與原始影像品質有很大的關係。若文件本身模糊、歪斜或有污漬,即使使用功能完整的軟體,也不一定能得到正確文字。
提高掃描解析度
如果能重新掃描紙本文件,應避免使用過低的解析度。對一般印刷文字而言,約 300 DPI 通常是實用的起點;細小文字或特殊文件可能需要更高解析度。
不過,解析度越高,檔案通常也越大,應依文件用途調整。
修正歪斜與背景雜訊
如果紙張放置不正、頁面有陰影或背景顏色不均,會增加辨識難度。
建議在 OCR 前先進行:
-
頁面旋轉與校正。
-
去除多餘黑邊。
-
改善對比度。
-
適度降低背景雜訊。
-
確認文字沒有被裁切。
如果原始影像品質很差,應優先改善來源,而不是一再使用不同工具重複辨識。
針對繁體中文文件檢查語言設定
繁體中文文件可能同時出現英文縮寫、數字、全形標點、表格及特殊符號。辨識後應特別檢查:
-
人名、地名與公司名稱。
-
金額、日期及電話號碼。
-
條文編號與產品型號。
-
表格欄位及合計數字。
-
中英文混合的專有名詞。
對於合約、報價單或財務資料,不應只憑 OCR 結果直接使用,應與原始頁面逐項核對。
表格與多欄排版需要額外檢查
OCR 可以辨識文字,不代表一定能完整還原原始排版。
例如,雙欄文章可能被讀成一整段文字,表格中的數字可能跑到錯誤欄位,頁首頁尾也可能混入正文。
如果需要完整編輯文件,建議將內容匯出至 Word 後,重新檢查段落、欄位、表格與分頁。
七、OCR 與 PDF 轉 Word 有什麼不同?
這兩種方法都可能讓你取得可複製的文字,但用途並不完全相同。
| 比較項目 | OCR 文字辨識 | PDF 轉 Word |
|---|---|---|
| 主要目的 | 將圖片中的文字轉為可讀取文字 | 將 PDF 內容轉成可編輯文件 |
| 適合對象 | 掃描 PDF、圖片型文件 | 已有文字層的 PDF,或已完成 OCR 的文件 |
| 是否可建立可搜尋文字層 | 支援此用途的工具可以 | 視轉換方式與來源而定 |
| 版面保留 | 取決於 OCR 工具及輸出設定 | 可能發生段落、表格及分頁變化 |
| 常見用途 | 搜尋、複製、文字擷取 | 修改內容、整理報告、編輯文件 |
如果 PDF 是掃描圖片,建議先進行 OCR,再依需求決定是否轉成 Word。
如果 PDF 原本就有可選取的文字,只是想修改內容,則可以先嘗試直接用 Word 開啟,不一定需要額外執行 OCR。
八、處理 PDF 無法複製文字時的注意事項
注意文件隱私與上傳風險
部分線上 OCR 服務需要將 PDF 上傳至遠端伺服器才能處理。如果文件包含身分證件、合約、公司機密、醫療紀錄或財務資訊,應優先考慮符合自身隱私需求的本機工具,並確認服務的資料處理政策。
不要覆蓋唯一的原始檔案
OCR、轉檔或重新儲存可能改變 PDF 的文字層、版面或其他內容。重要文件應先備份,並保留原始版本,以便日後核對。
OCR 不等於文件內容驗證
OCR 的作用是辨識文字,不是確認文字是否正確,也不會自動判斷文件內容是否真實。
對於合約、法律條文、帳務數字及正式報告,務必與原始掃描影像核對,避免因一個字或數字辨識錯誤而產生後續問題。
常見問題 (FAQ)
總結:先判斷原因,再選擇合適的 OCR 工具
PDF 無法複製文字,不一定代表檔案損壞。最重要的是先判斷文件究竟是掃描圖片、缺少文字層、受到權限限制,還是文字編碼本身有問題。
如果是掃描圖片,使用 OCR 建立可搜尋的文字層,通常是最直接的處理方式;如果只是想編輯文件,則可以評估 Word 轉換;若只需要擷取少量內容,也可以使用支援圖片文字辨識的工具。
完成辨識後,記得測試文字是否能反白、複製與搜尋,並核對錯字、表格及重要數字。只要先選對方法,就能減少反覆轉檔的時間,讓原本只能閱讀的 PDF 更容易搜尋、整理與使用。